Vous avez une image qui vous plaît et elle ne bouge pas. Une photo de produit posée sur un fond neutre, une illustration générée la veille, un portrait, un souvenir de famille. Dans un fil d'actualité, elle passe sans être vue, parce que le pouce ne s'arrête presque plus sur du fixe. L'image en vidéo IA répond exactement à ce manque : votre image devient le premier photogramme d'un clip, et le modèle fabrique les secondes qui suivent.
Le geste a l'air simple, et il l'est devenu : une image, une phrase, un clip. Ce qui reste difficile, c'est d'obtenir le plan que vous aviez en tête plutôt qu'un mouvement approximatif qui abîme votre image. La plus grande partie du résultat se joue avant la génération, dans le choix de l'image et dans la façon de décrire le mouvement. Ce guide reprend la chaîne complète, telle qu'elle fonctionne dans le studio de création EasyVids comme ailleurs.
La réponse courte
Transformer une image en vidéo avec l'IA tient en trois temps. Vous fournissez une image, vous décrivez en une ou deux phrases le mouvement voulu, le modèle rend un clip de quelques secondes dont votre image est le point de départ. Le modèle ne part pas d'une page blanche : il prolonge dans le temps ce que vous lui donnez. C'est toute la différence avec le texte vers vidéo, où la scène entière est inventée, et c'est ce qui rend l'approche intéressante : vous gardez la main sur ce qu'on voit. Notre guide du générateur vidéo par intelligence artificielle pose le cadre général dont ce texte est le chapitre image.
Ce que le modèle garde de votre image, ce qu'il réinvente
Un modèle image vers vidéo reçoit deux entrées : votre image, et un texte qui décrit le mouvement. Il produit une suite de photogrammes qui commence par votre image, ou par une image très proche. Le mot important est proche. Les couleurs, la composition, la lumière et le sujet sont repris fidèlement. Tout ce qui bouge, en revanche, est recalculé photogramme par photogramme, et ce qui est recalculé peut dériver.
Cette dérive n'est pas un défaut de fabrication, c'est la mécanique elle-même. Le modèle prédit ce qui vient après, sans rien savoir de ce que vous savez de la scène. Il ignore que la personne au second plan est votre soeur, que l'étiquette du flacon porte un nom précis, que la main tient un objet particulier. Plus la séquence dure, plus il s'éloigne de votre image de départ. Sur nos générations, les défauts apparaissent presque toujours dans le dernier tiers du clip, jamais dans les premières images.
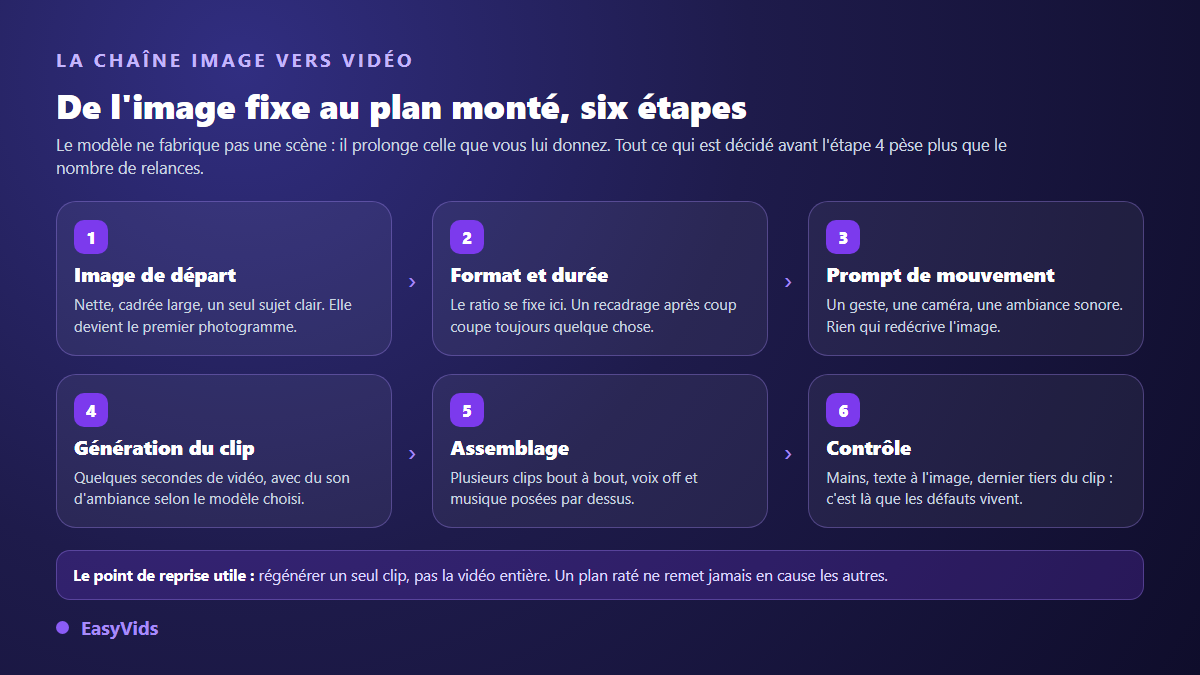
D'où la première règle de travail : demandez le plus petit mouvement qui raconte quelque chose. Un souffle de vent dans les cheveux, un regard qui se lève, une caméra qui avance de quelques centimètres. Les plans les plus courts et les plus sobres sont ceux qui sortent propres, et ce sont aussi ceux qui se remarquent le moins une fois posés dans un montage.
Pourquoi partir d'une image plutôt que d'un texte
Le texte vers vidéo décrit une scène qui n'existe pas encore. Vous obtenez une proposition du modèle, souvent belle, rarement celle que vous imaginiez. L'image vers vidéo inverse le rapport de force : la scène est déjà fixée, validée, cadrée par vous. Le modèle n'a plus qu'à lui donner de la durée. Pour un travail de commande, une fiche produit ou une série de plans qui doivent se ressembler, c'est le seul chemin qui tient sur la longueur.
Trois usages en découlent naturellement. Animer des images que vous possédez déjà, produits, lieux, archives. Générer d'abord une image, la corriger jusqu'à ce qu'elle soit exactement bonne, puis l'animer, ce qui revient à ne demander un mouvement que sur un visuel validé. Enfin garder le même décor et le même personnage d'un plan à l'autre, en repartant à chaque fois de la même image de référence. Nos sept façons de donner du mouvement à une photo détaillent les techniques disponibles pour le premier cas.
L'image de départ décide de l'essentiel
Le réflexe du débutant consiste à relancer le prompt quand le clip déçoit. Le plus souvent, le problème est en amont : l'image ne pouvait pas s'animer proprement. Une photo floue donne un flou qui se met à bouger tout seul. Un visage minuscule dans le cadre change de traits en cours de route, parce que le modèle n'a pas assez de matière pour le tenir. Un sujet collé au bord finit hors champ dès que la caméra bouge.
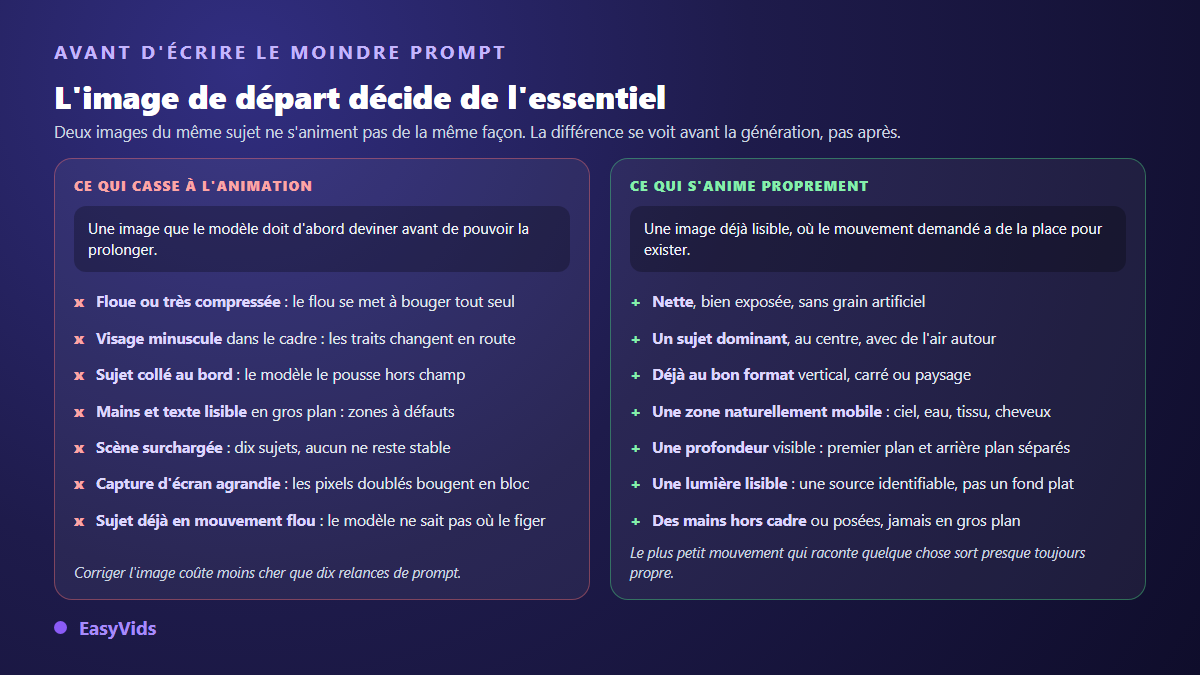
- La netteté. Une image nette et bien exposée, sans grain ajouté ni agrandissement forcé.
- Un sujet dominant. Un point d'intérêt clair, plutôt au centre, avec de l'air autour de lui.
- Le bon format dès le départ. Vertical, carré ou paysage, décidé avant la génération et non au recadrage.
- Une zone naturellement mobile. Un ciel, de l'eau, un tissu, des cheveux : le modèle a quelque chose à animer sans rien inventer.
- De la profondeur. Un premier plan et un arrière plan distincts, ce qui rend crédible n'importe quel mouvement de caméra.
- Les mains et le texte hors des gros plans. Ce sont les deux zones où les défauts se voient le plus vite.
- Une lumière lisible. Une source identifiable plutôt qu'un éclairage plat, sinon les ombres se mettent à glisser.
Si votre image ne coche pas ces cases, réparez-la avant de l'animer. Recadrer, gagner en netteté, remonter la définition, retirer un élément parasite : chacune de ces opérations prend une minute et évite une série de clips ratés. Sur une photo ancienne, la restauration passe toujours avant l'animation, sinon les rayures et le grain se mettent à vivre eux aussi.
Décrire le mouvement, pas ce que l'image montre déjà
Voici l'erreur la plus fréquente, et elle est contre-intuitive. Face au champ de texte, on redécrit la photo : un homme dans un café, lumière chaude, très détaillé. Le modèle reçoit alors une commande de fabrication alors qu'on lui demandait une animation, et il refabrique la scène. Le visage glisse, le décor se réorganise, et il ne se passe rien pendant six secondes. Le prompt d'une image vers vidéo ne décrit pas l'espace, il décrit le temps.
Trois lignes suffisent presque toujours : ce que fait le sujet, ce que fait la caméra, ce qu'on entend. Un verbe d'action qui a un début et une fin, un seul mouvement de caméra, et une consigne sonore explicite pour éviter qu'une musique arrive sans prévenir. Ajoutez une phrase d'identité quand un visage compte, du type mêmes traits, même coiffure et même tenue que l'image fournie. Nos vingt et un exemples de prompts pour animer une photo donnent les formulations exactes, couche par couche.
Format, durée et cadrage se décident avant, jamais après
Le format d'une vidéo générée à partir d'une image suit d'abord celui de l'image. Fournir une photo paysage en espérant un rendu vertical revient à demander au modèle de deviner ce qui manque à gauche et à droite : il l'invente, et cela se voit. Préparez l'image au format visé, puis vérifiez que ce format est bien celui qui sera exporté, sans recadrage intermédiaire glissé entre la génération et le montage.
La durée obéit à une contrainte technique simple. Les modèles image vers vidéo produisent des clips courts, de l'ordre de quelques secondes, et la qualité se dégrade avec la longueur. Dans notre studio, les plans sont découpés à six secondes, ce qui correspond à peu près à ce qu'un modèle tient sans dériver. Une vidéo plus longue ne s'obtient pas en demandant un clip plus long : elle s'obtient en enchaînant plusieurs clips courts.
Cinq situations, cinq mouvements différents
Une photo de produit, un portrait, une illustration et une archive familiale n'appellent pas le même traitement. Le mouvement qui met l'un en valeur abîme l'autre. La grille ci dessous résume ce qui marche dans les cinq cas les plus demandés, avec le point de contrôle propre à chacun.
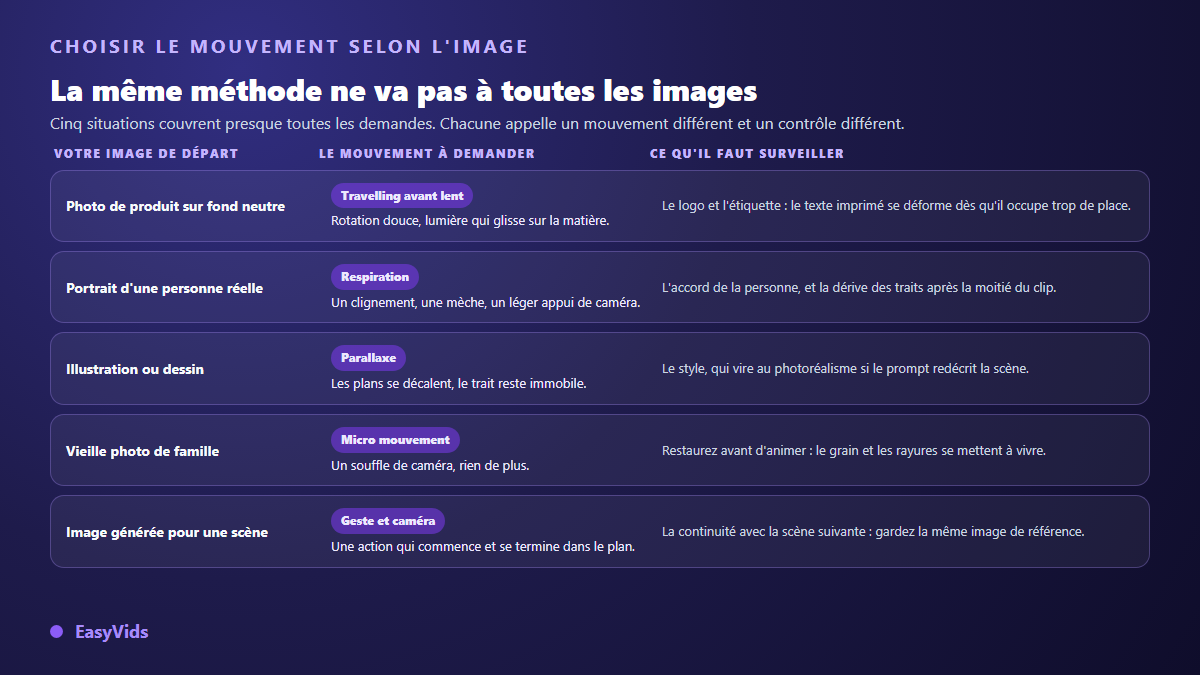
Le cas commercial mérite une note à part. Sur une photo de produit, le mouvement gagnant est presque toujours un travelling avant lent ou une lumière qui glisse sur la matière, jamais une rotation complète qui oblige le modèle à inventer la face cachée de l'objet. Notre guide de la pub construite à partir d'une seule photo de produit déroule ce cas de bout en bout.
Passer d'un clip isolé à une vraie vidéo
Un clip de six secondes ne fait pas une vidéo. Ce qui fait une vidéo, c'est une suite de plans qui se répondent, une voix qui porte le propos et un son qui tient l'ensemble. La méthode qui marche consiste à écrire d'abord le découpage : une phrase par plan, une image par phrase, un mouvement par image. Vous générez ensuite les images, vous les animez une par une, et vous posez la voix off par dessus le montage terminé. Comme une bonne part des spectateurs regardera ces plans sans le son, terminez par un passage dans un générateur de sous-titres précis en français, qui rend le propos lisible même muet.
Deux techniques évitent l'effet catalogue. La première consiste à repartir de la dernière image d'un clip pour générer le suivant, ce qui donne un raccord invisible entre deux plans. La seconde consiste à garder les mêmes images de référence pour tous les plans où le même personnage apparaît, sans quoi son visage change d'un plan à l'autre. Ce problème précis a son propre mode d'emploi, détaillé dans notre méthode pour garder le même personnage d'une scène à l'autre.
Les défauts qui reviennent, et le geste qui les corrige
Cinq symptômes reviennent sur presque toutes les générations ratées. Aucun ne demande de tout réécrire : chacun désigne la couche à corriger.
- Rien ne bouge. Le prompt contient des adjectifs mais aucun verbe d'action : ajoutez un geste qui commence et se termine dans le plan.
- Le visage n'est plus le même à la fin. Ajoutez la phrase d'identité, et fournissez une image où le visage occupe une vraie place dans le cadre.
- Le décor se réorganise. Retirez du prompt tout ce qui redécrit l'image : chaque mot recopié invite le modèle à refabriquer la scène.
- Le cadre est rogné ou étiré. L'image de départ n'était pas au format demandé : reprenez le cadrage avant de relancer quoi que ce soit.
- Une voix ou une musique surgit. Demandez explicitement le silence, ou la seule ambiance du lieu, sinon le modèle comble le vide sonore.
Faire parler l'image, un cas à part
Animer une image et lui faire prononcer un texte sont deux opérations différentes. La première ajoute du mouvement, la seconde synchronise une bouche sur une bande son, avec ses propres outils et ses propres limites. Si votre objectif est un visage qui s'adresse au spectateur, c'est le second chemin qu'il faut prendre, et notre article sur la synchronisation d'une voix sur un visage qui parle en donne la méthode. Mélanger les deux dans une même demande donne en général une bouche qui bouge sans rien dire.
Droits, consentement et déclaration avant publication
Trois vérifications valent la peine, et elles prennent une minute. Avez-vous le droit d'utiliser l'image de départ ? Les licences des banques d'images encadrent souvent la modification et l'usage dans une oeuvre dérivée, et une photo trouvée dans un moteur de recherche n'est jamais libre par défaut. La personne visible sur la photo a-t-elle donné son accord ? Animer le portrait d'une personne identifiable engage son droit à l'image, et un accord écrit reste la seule protection sérieuse, y compris pour un usage interne.
Reste la déclaration. Le centre d'aide YouTube demande depuis 2024 de signaler, au moment de la mise en ligne, une vidéo qui présente du contenu réaliste altéré ou généré de façon synthétique, et les règles communautaires de TikTok imposent d'étiqueter de la même façon les contenus réalistes créés par IA. Sur le versant technique, la norme C2PA, publiée par la Coalition for Content Provenance and Authenticity, définit des métadonnées de provenance attachées au fichier lui-même. Le règlement européen sur l'intelligence artificielle prévoit pour sa part, à son article 50, une obligation d'information pour les contenus qui ressemblent à des personnes ou à des événements réels. Une vague animée ou un produit qui tourne ne pose aucune question ; un visage réaliste demande de cocher la case.
Où animer une image dans EasyVids
Le parcours Réalisateur rend la chaîne explicite. Chaque scène reçoit d'abord son image, construite à partir des références du projet ou importée depuis votre ordinateur, puis cette image est animée par un prompt vidéo qui lui est propre. Les deux champs sont séparés à l'écran, et le second ne demande qu'une chose : le mouvement, la caméra, la dynamique de la scène. Vous modifiez ce texte scène par scène, vous relancez une seule vidéo sans toucher aux autres, et vous demandez une réécriture assistée quand un prompt s'est fait refuser par les filtres. Ce que consomme chaque génération se compte en crédits, et le détail vit sur la page des tarifs.
Questions fréquentes
Quelle taille d'image faut-il fournir pour une bonne animation ?
Visez au moins la définition de sortie que vous voulez, soit 1080 pixels de large pour une vidéo verticale courante. En dessous, le modèle travaille sur trop peu de détail et la dérive arrive plus vite. Un agrandissement artificiel ne remplace pas une image nette : il fabrique des pixels qui bougeront en bloc au moment de l'animation.
Combien de temps peut durer un clip généré à partir d'une image ?
Quelques secondes, selon le modèle utilisé. La qualité se dégrade avec la longueur, et la fourchette vraiment exploitable reste courte. Pour une vidéo de plusieurs minutes, on enchaîne des clips courts au montage plutôt que de demander un clip long, qui dérive presque toujours dans sa dernière partie.
Peut-on animer une image générée par une autre IA ?
Oui, et c'est même le cas le plus confortable, puisque vous corrigez l'image autant de fois que nécessaire avant de demander le moindre mouvement. Vérifiez simplement les conditions d'utilisation de l'outil qui a produit l'image, en particulier si votre vidéo a un usage commercial.
Pourquoi le visage change-t-il alors que je fournis une photo ?
Parce que chaque photogramme est recalculé et que le modèle ne dispose pas d'une définition suffisante du visage pour le tenir jusqu'au bout. Deux gestes règlent la majorité des cas : fournir une image où le visage occupe une part réelle du cadre, et ajouter une consigne d'identité qui exige les mêmes traits du premier au dernier photogramme.
Faut-il écrire le prompt de mouvement en anglais ?
Non. Les modèles récents comprennent le français, et la clarté compte davantage que la langue. Une consigne courte, ordonnée, sans adjectif décoratif, donne un meilleur résultat qu'un long texte anglais approximatif dont vous ne maîtrisez pas les nuances.
La bonne façon de commencer n'est pas de chercher le modèle parfait, c'est de prendre une image que vous aimez déjà, de lui demander un seul mouvement simple, et de regarder ce qui sort. Une génération vous apprendra ce qu'aucun texte ne vous dira : ce que votre image supporte, et ce qu'elle refuse. La suite se construit plan par plan, à partir de ce premier constat. Ouvrez un compte EasyVids et animez votre première image aujourd'hui.