Vous décrivez une scène en une phrase, et une image sort quelques secondes plus tard. Le texte en image IA fait exactement cela, et la première fois c'est bluffant. La deuxième fois, beaucoup moins : le personnage ne regarde pas dans la bonne direction, la lumière est plate, le décor a changé alors que vous n'aviez touché à rien. Vous relancez, vous empilez des adjectifs, et rien ne s'améliore vraiment.
Le problème n'est presque jamais le modèle. Il vient de ce que l'on croit qu'il fait. Tant que l'on imagine une machine qui comprend une consigne comme un graphiste la comprendrait, on écrit des prompts qui ne peuvent pas fonctionner. Cet article prend le sujet par l'autre bout : ce qui se passe réellement entre votre phrase et le fichier image, puis la méthode d'écriture qui en découle. Pour la vue d'ensemble de l'outil et de ses usages, notre guide du générateur d'images IA couvre le terrain.
La réponse courte
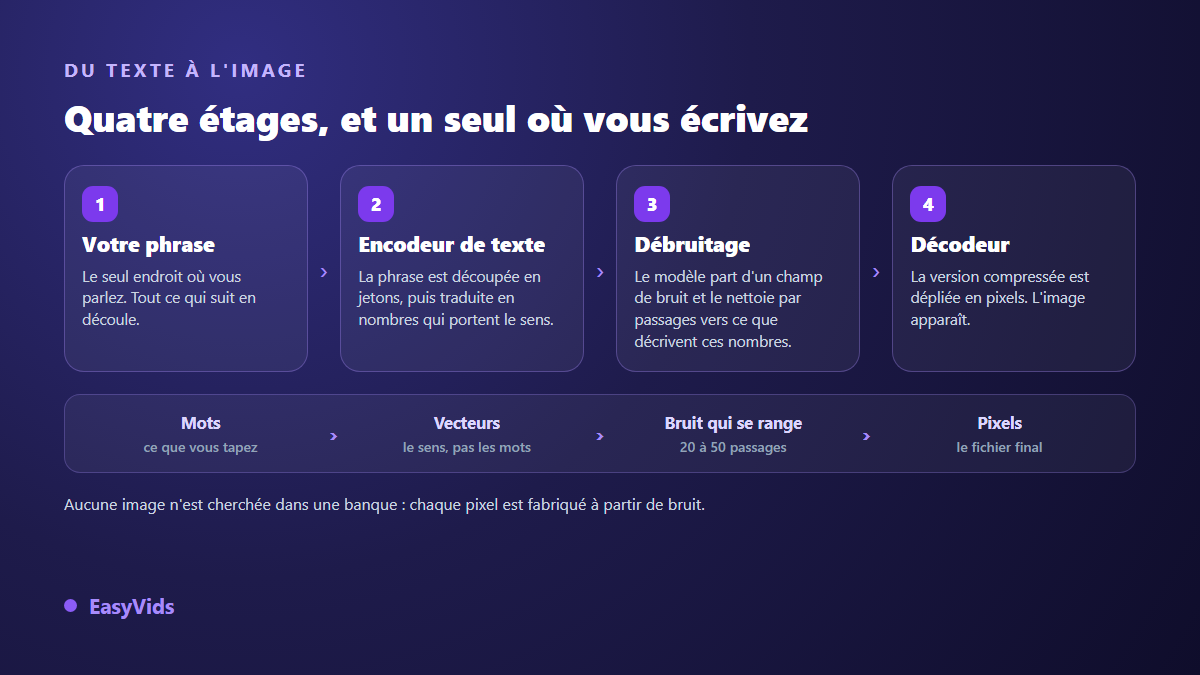
Un générateur de texte en image ne va pas chercher une image existante : il en fabrique une à partir d'un champ de bruit aléatoire, qu'il nettoie par passages successifs. Votre phrase ne lui donne pas un ordre, elle lui donne une direction. Elle est transformée en une suite de nombres qui décrivent un sens, et ces nombres orientent le nettoyage à chaque passage. La conséquence pratique tient en une règle, et c'est toute la méthode : décrivez ce qui est visible, jamais ce que vous ressentez. Un mot qui ne désigne rien d'observable ne peut rien guider.
Le modèle ne cherche pas une image, il en fabrique une
L'idée fausse la plus répandue veut que ces outils recollent des morceaux d'images vues pendant l'entraînement. Ce n'est pas ce qui se produit. Ce que le modèle a retenu de millions d'exemples, ce sont des régularités : à quoi ressemble une ombre portée, comment un tissu tombe sur une épaule, quelle texture accompagne le mot céramique. Aucune de ces images n'est rangée dans le fichier du modèle, dont le poids se compte en gigaoctets là où les données d'entraînement se comptaient en téraoctets.
Cette différence change votre façon d'écrire. Vous ne sélectionnez pas dans un catalogue, vous décrivez une cible. Plus la description désigne des choses observables, plus la cible est nette. Plus elle empile des jugements de valeur, plus la cible se dilue, et le modèle retombe alors sur sa moyenne : le plan moyen, la lumière frontale, le sujet centré. C'est exactement l'image sans caractère que tout le monde obtient au premier essai.
Étape 1 : votre phrase devient des nombres
La première chose qui arrive à votre texte, c'est un découpage en jetons, des fragments de mots. Ces jetons traversent ensuite un encodeur de texte, un réseau entraîné à rapprocher une description et l'image qui lui correspond. Le plus connu, CLIP, publié par OpenAI en 2021, travaille sur une fenêtre de 77 jetons seulement, marqueurs de début et de fin compris. Sur les modèles bâtis autour de lui, ce qui dépasse cette fenêtre est purement ignoré.
Voilà l'explication mécanique d'une chose que tout le monde a constatée sans se l'expliquer : passé une certaine longueur, ajouter des mots ne change plus rien. Les générations plus récentes ont élargi cette fenêtre en doublant ou en remplaçant cet encodeur par des modèles de langue plus vastes, ce qui leur permet de suivre des consignes longues et des relations entre objets. La règle de prudence, elle, ne bouge pas : mettez en tête de phrase ce qui compte le plus, parce que le début pèse toujours davantage que la fin.
Étape 2 : le débruitage, l'idée qui a tout fait basculer
Le cœur du système tient dans un renversement. Plutôt que d'apprendre à dessiner, le modèle a appris à enlever du bruit. Pendant l'entraînement, on prend une vraie image, on y ajoute du bruit par petites doses jusqu'à ce qu'il n'en reste qu'une neige informe, et on demande au réseau de retrouver, à chaque dose, ce qui vient d'être ajouté. La méthode a été formalisée en 2020 dans l'article de recherche « Denoising Diffusion Probabilistic Models », qui a donné son nom à toute la famille des modèles de diffusion.
À l'usage, tout se déroule à l'envers. On part d'un champ de bruit pur, et le modèle le nettoie par passages successifs en se posant chaque fois la même question : si cette image devait finir par correspondre à cette description, à quoi ressemblerait-elle un cran plus loin ? Votre phrase intervient à chacun de ces passages, comme une boussole. Elle ne dessine rien, elle indique la direction dans laquelle nettoyer.
Restait un problème de coût. Nettoyer du bruit directement sur des millions de pixels demanderait un calcul énorme. L'article « High-Resolution Image Synthesis with Latent Diffusion Models », présenté à la conférence CVPR en 2022, a déplacé l'opération dans un espace compressé, l'espace latent, où une image tient en quelques milliers de valeurs au lieu de plusieurs millions. Le débruitage s'y déroule, puis un décodeur déplie le résultat en pixels. C'est ce raccourci qui a rendu la génération d'images accessible depuis un navigateur.
Retenez surtout ceci : cette compression explique une bonne part des défauts que vous voyez. Les petits détails, un texte, des doigts, un motif fin, sont ceux qui souffrent le plus du passage par l'espace compressé, parce qu'ils occupent peu de place et pèsent donc peu dans le calcul. Ce ne sont pas des accidents, ce sont les endroits où la méthode est structurellement la plus fragile.
Les trois curseurs qui commandent le résultat
Au delà de la phrase, trois réglages décident de ce que vous obtenez. La plupart des interfaces grand public les masquent pour simplifier, mais ils existent toujours en arrière plan, et comprendre leur rôle change complètement la façon de relancer une image.
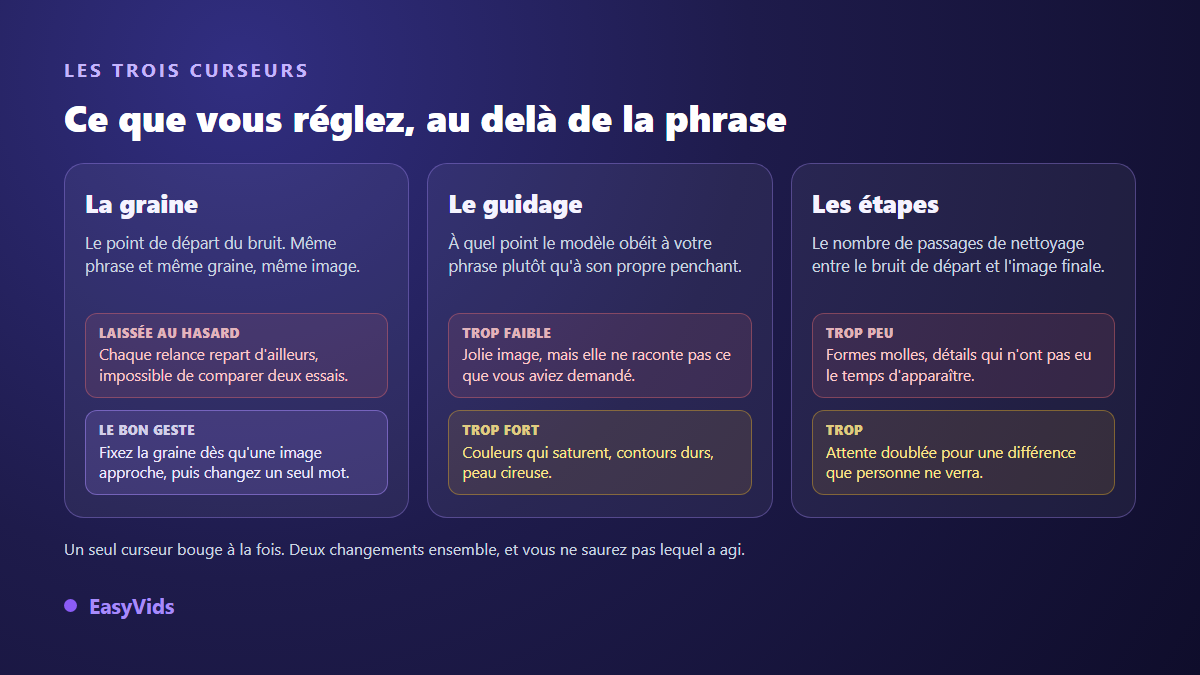
- La graine décide du champ de bruit de départ. Deux générations qui partagent la même phrase et la même graine donnent la même image, au pixel près.
- Le guidage dose l'obéissance à votre texte. Trop bas, l'image est jolie mais hors sujet. Trop haut, les couleurs saturent, les contours durcissent et la peau devient cireuse.
- Le nombre d'étapes compte les passages de nettoyage. En dessous d'une vingtaine, les formes restent molles. Très au dessus, vous doublez l'attente sans gain visible.
- Le format n'est pas un recadrage : il change la composition que le modèle produit. Un même sujet ne se cadre pas pareil en vertical et en horizontal.
- L'image de départ, quand l'outil l'accepte, remplace le bruit initial par votre visuel. C'est ce qui permet de garder une composition ou un visage d'une génération à l'autre.
Le geste qui fait progresser une série tient en une ligne : dès qu'une image approche de ce que vous voulez, fixez la graine, puis ne changez qu'un seul élément à la fois. Sans cela, vous comparez deux images qui diffèrent par tout, et vos essais ne vous apprennent rien.
Ce que le modèle exécute, et ce qu'il laisse tomber
Tous les mots d'un prompt n'ont pas le même poids. Certains désignent quelque chose de visible et se retrouvent dans l'image. D'autres n'ont aucune traduction visuelle et occupent de la place pour rien, en diluant au passage ceux qui comptent.
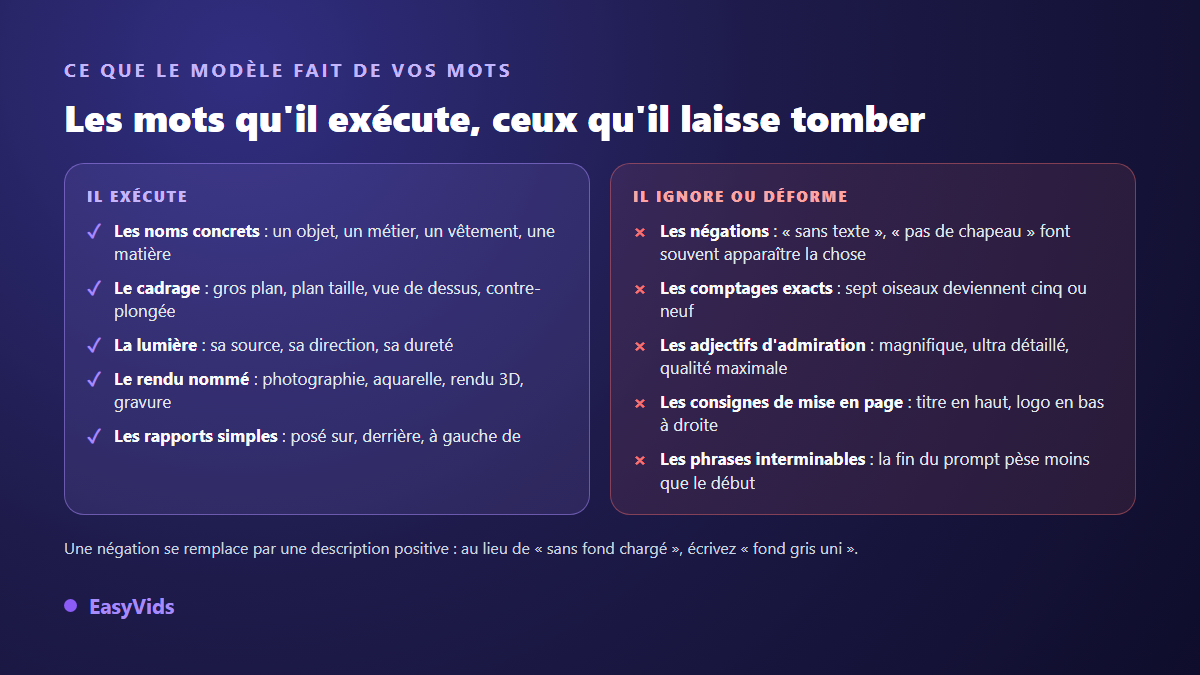
Le cas de la négation mérite un arrêt, parce qu'il surprend tout le monde. Écrire « sans chapeau » place bel et bien le mot chapeau dans la description encodée, et augmente donc les chances d'en voir un. Le modèle ne dispose d'aucun opérateur « ne pas ». La formulation qui marche est positive : « cheveux courts, tête nue ». Quand l'outil propose un champ de prompt négatif séparé, c'est là, et seulement là, que se déclarent les éléments à écarter.
Écrire un prompt : quatre passes, dans cet ordre
Une fois le mécanisme compris, l'écriture devient une procédure plutôt qu'une inspiration. Première passe, décrivez le sujet comme si vous le dictiez à quelqu'un qui doit le dessiner sans jamais le voir : ce qu'il est, ce qu'il porte, ce qu'il fait. Deuxième passe, prenez les décisions que le modèle prendra à votre place si vous vous taisez, à savoir le cadrage, l'angle, la source de lumière et sa direction. Ce sont elles qui séparent une image plate d'une image tenue.
Troisième passe, nommez le rendu : photographie, illustration à l'encre, rendu 3D, gravure. C'est le segment qui assure la cohérence d'une série entière, et celui auquel il ne faut plus toucher une fois trouvé. Quatrième passe, relisez et supprimez tout ce qui ne se voit pas, les adjectifs d'admiration et les intentions en premier. Pour voir cette ossature appliquée à des cas concrets, portrait, produit, décor ou couverture, nos 21 prompts commentés en français déroulent chaque fois les mêmes segments.
Pourquoi la même phrase ne donne jamais deux fois la même image
C'est la question que tout le monde finit par poser, et la réponse tient à la graine. Chaque génération commence par un champ de bruit tiré au hasard. Le prompt oriente le nettoyage, il ne fixe pas le point de départ. Deux départs différents mènent à deux destinations différentes, même avec une boussole identique. Ce n'est donc pas une instabilité de l'outil, c'est son fonctionnement normal.
Cela vous donne un levier plutôt qu'une contrainte. Générez quelques images d'un même prompt pour explorer, choisissez celle dont la composition vous convient, relevez sa graine, puis affinez le texte en gardant cette graine. Vous passez de la loterie au réglage. Sur nos générations, c'est ce seul changement d'habitude qui fait le plus baisser le nombre de relances, bien avant le choix du modèle.
Corriger au lieu de tout relancer
Quand une image tombe à côté, le réflexe courant consiste à réécrire le prompt en entier. C'est le meilleur moyen de tourner en rond. Diagnostiquez d'abord. Si le sujet est faux, le problème est dans la première passe. Si le sujet est bon mais l'image plate, il manque le cadrage et la lumière. Si le style change d'une image à l'autre, le segment de rendu est absent ou trop vague. Si un détail parasite persiste, il est souvent nommé quelque part dans votre phrase, y compris sous forme de négation.
Deuxième réflexe utile : beaucoup de corrections ne passent plus par le texte du tout. Repartir de votre propre image et demander une modification locale, changer un fond, retirer un objet, ajuster une couleur, donne un résultat plus fiable qu'un nouveau prompt, parce que la composition déjà validée est conservée.
Les limites qui tiennent encore, et leur explication
Trois faiblesses reviennent sans cesse, et elles s'expliquent toutes par la mécanique décrite plus haut. Les mains d'abord : elles occupent peu de pixels, prennent un nombre de poses considérable et ne pardonnent aucune erreur de comptage, ce que détaille notre analyse des mains ratées par l'IA. Le texte écrit dans l'image ensuite, pour la même raison de finesse, avec en plus un modèle qui a appris des formes de lettres et non une orthographe : c'est le sujet de notre guide du texte lisible dans une image.
Le comptage exact enfin. Demander sept objets en donne cinq ou neuf, parce qu'aucune étape du processus ne compte quoi que ce soit : le modèle ajuste des textures et des formes, il ne dénombre pas. La parade est la même dans les trois cas, et elle est peu glorieuse mais efficace : ne demandez pas au modèle ce qu'il ne sait pas faire. Cadrez autrement, écrivez le texte par dessus l'image après coup, ou composez la quantité vous même.
Le format et la définition se décident avant, pas après
Le format demandé influence la composition elle même, parce que le modèle a appris que certains cadrages accompagnent certaines proportions. Générer en carré puis recadrer en vertical coupe presque toujours quelque chose d'important. Décidez donc de la destination avant de lancer : miniature horizontale, visuel vertical pour les réseaux, bannière large. Pour la définition, produire un peu au dessus de votre besoin puis réduire donne une image plus propre que l'inverse, un agrandissement restant une reconstruction.
Ces images ne vivent pas seules très longtemps. Une image générée devient un plan de vidéo dès qu'on l'anime, et c'est même le point de départ le plus fiable pour tenir un style d'un plan à l'autre, comme le montre notre guide du générateur vidéo IA. Le studio EasyVids réunit ces deux étapes au même endroit, et le détail des formules se trouve sur la page des tarifs.
Questions fréquentes
Faut-il écrire son prompt image en français ou en anglais ?
Les modèles récents comprennent le français, mais leur vocabulaire visuel a été appris surtout sur des légendes anglaises. Sur les termes techniques de photographie et de style, l'anglais reste plus précis. En pratique, écrivez en français et gardez en anglais les seuls mots de métier qui n'ont pas d'équivalent stable, ou passez par un outil qui traduit la phrase avant de l'envoyer au modèle.
Quelle longueur doit faire un prompt image ?
Assez pour couvrir le sujet, le cadrage, la lumière, le décor et le rendu, rarement plus. Sur les modèles bâtis autour d'un encodeur CLIP, ce qui dépasse la fenêtre de 77 jetons n'est jamais lu, soit une soixantaine de mots en français. Les modèles plus récents lisent nettement plus long, mais la hiérarchie ne change pas : ce qui est écrit en tête pèse plus lourd que ce qui traîne à la fin.
Le générateur copie-t-il des images existantes ?
Non. Aucune image n'est stockée dans le modèle, et chaque résultat est fabriqué à partir de bruit. Des travaux de recherche publiés en 2023 sur l'extraction de données d'entraînement ont montré qu'un modèle peut restituer une image quasi identique à un original, mais uniquement pour des visuels dupliqués un très grand nombre de fois dans les données, comme des affiches célèbres. Sur une description ordinaire, le cas ne se présente pas.
Peut-on reconnaître une image générée par IA ?
Souvent oui, à l'œil, sur des indices récurrents : mains, oreilles, reflets incohérents, texte déformé, symétries trop parfaites. Côté technique, la norme C2PA, portée par la Coalition for Content Provenance and Authenticity, définit un manifeste signé attaché au fichier pour déclarer son origine, mais il disparaît dès qu'une plateforme réencode l'image. Les neuf indices qui trahissent une image générée donnent la liste complète.
Faut-il un ordinateur puissant pour générer des images ?
Non, si vous passez par un service en ligne : le calcul tourne sur des serveurs et votre appareil ne fait qu'afficher le résultat, ce qu'un téléphone suffit à faire. Une installation locale réclame en revanche une carte graphique avec une mémoire vidéo confortable, et reste réservée à ceux qui veulent modifier les modèles eux mêmes.
Reprenez un prompt qui vous a déçu et appliquez les quatre passes dans l'ordre, sans rien ajouter d'autre : dans la plupart des cas, l'image change plus qu'après dix relances au hasard. Fixez ensuite la graine, changez un mot, comparez. C'est cette boucle courte qui construit peu à peu une bibliothèque de formulations qui vous appartiennent. Créez votre compte pour éprouver la méthode sur vos propres visuels, et pour les animer quand ils vous conviendront.